Blog · Bölüm 1/3 · GenAI sistemlerinde test ve değerlendirme
Yanlış veri, eksik veriden pahalıdır
GenAI destekli bir veri hattında iki aşamalı doğrulamayı nasıl kurdum ve modele neden son sözü vermedim
- tek karar verici: kurallar
- 2 aşama
- LLM'in gördüğü örneklem
- ≤ 100 satır
- boş değer için kapalı liste
- 6 neden
- kabul edilen fazla beyan
- 83'ten 0'a
Kısa özet
- Kurduğum doğrulama iki aşamalı, ama iki aşamanın yetkisi eşit değil. Kararı deterministik kurallar veriyor; LLM yalnızca yorum yapıyor ve bir hükmü ancak sıkılaştırabiliyor.
- Modelin bulduğu her yeni sorun tipi bir kurala çevriliyor ve her koşuda yeniden ölçülüyor. Model keşfediyor, ölçmeyi kod yapıyor.
- Emin olmadığım değeri yazmıyorum. Boş bırakıyor, nedenini kapalı bir listeden seçiyorum; nedensiz boş değer şemadan geçemiyor.
- Ajanın “başardım” demesi kanıt sayılmıyor. Değerlendiricinin FAIL dediği koşularda kabul edilen fazla beyan 83’ten 0’a indi.
Mutlu yol bir başarı ölçütü değil
GenAI ile çalışan çoğu ekip aynı anı yaşar. Demo kusursuz çalışır, ilk hafta her şey yeşildir. Sonra girdiler biraz değişir, bağımlı olduğunuz bir servis bir gün yavaşlar, model bir ifadeyi farklı yorumlar. Sistem yine “başarılı” der; ama çıkan veri artık doğru değildir.
Bu yazıda, LLM ajanlarının yardımıyla yapılandırılmamış girdilerden yapılandırılmış veri üreten bir sistemde bu anla nasıl yüzleştiğimi anlatacağım. Sistemin kendisi bu yazının konusu değil. Konu, yol boyunca öğrendiğim ve başka GenAI sistemlerine de taşınabileceğini düşündüğüm mühendislik dersleri.
Başladığım soru basitti: koşullar değiştiğinde sistem sessizce yanlış veri mi üretiyor, yoksa görünür biçimde mi bozuluyor? İkincisi bir arıza; birincisi bir güven kaybı. Ben ikincisini seçmek istedim ve bunu mimariye yazdım.
Kurallar hesaplar, model yorumlar
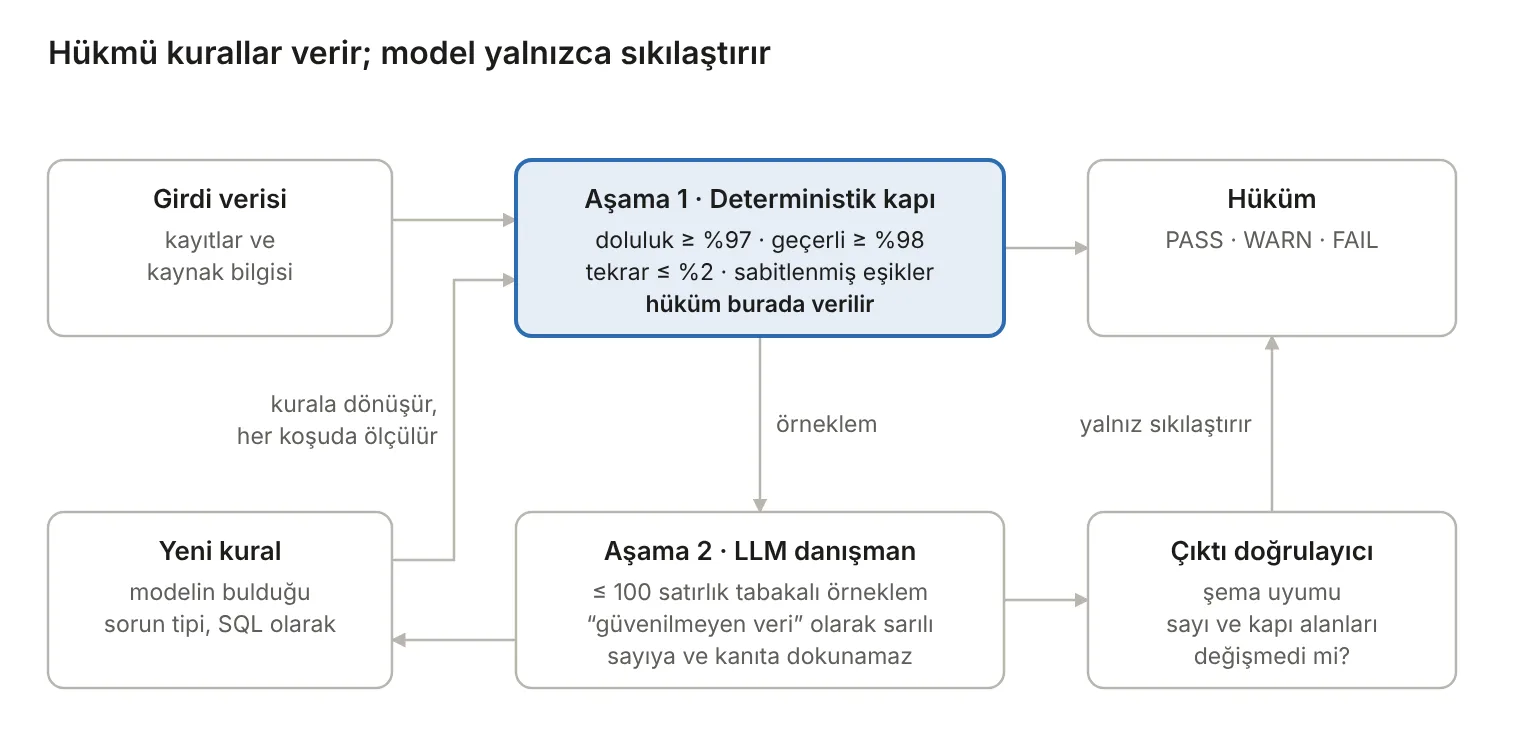
“İki aşamalı doğrulama” deyince çoğu kişinin aklına önce kurallar, sonra bir LLM hakem geliyor. Benimki biraz farklı: iki aşamanın yetkisi bilinçli olarak eşit değil. Birinci aşama hükmü veriyor. İkinci aşama yalnızca danışıyor.
Birinci aşama tamamen deterministik. Kritik alanların en az %97’si dolu olmalı, geçerli sayısal değer oranı %98’in altına inmemeli, tekrar eden kayıtlar %2’yi geçmemeli. Bu eşikler her girdi kaynağının yapılandırmasında açıkça beyan ediliyor ve hata listesi boş değilse PASS yok. “Çoğunlukla geçti” diye bir sonuç tanımlamadım.
Veri sağlığı kapısının eşikleri ise tek bir dosyada, bir hash ile sabitlenmiş durumda. Biri eşiği sessizce gevşetirse hash tutmuyor ve o kapıdaki bütün kontroller FAIL veriyor. Bir eşiği değiştirmek meşru olabilir; ama görünmez olmamalı.
Sayılar, birimler, bağlantılar ve kodlar gibi alanlarda LLM yargıç hiç kullanmıyorum. Bunların doğru cevabı bellidir; bir modelin “bence doğru” demesine ihtiyaç yok. Karşılaştırmadan önce kural tabanlı bir normalizasyon katmanı çalışıyor: sayı ve para biçimleri, birim dönüşümleri, URL kanonlaştırma, boşluk ve büyük-küçük harf katlama.
Modelin yetkisini mimari sınırlıyor
LLM ikinci aşamada bir danışman. Ama “danışman” bir rica değil, kodun zorladığı bir sınır. Dört kural var:
- Yalnız sıkılaştırır. Model PASS’i WARN’a çekebilir; FAIL’i PASS’e çeviremez.
- Şemaya uyar. Modelin çıktısı, veri modelinden üretilmiş bir JSON şemasına uymak zorunda. Uymayan çıktı FAIL sayılır.
- Sayıya dokunmaz. Ayrı bir doğrulayıcı, modelin sayılara, kanıt alanlarına ve kapı kararlarına dokunmadığını denetler. Model yalnızca açıklama metnini inceltebilir.
- Kendini kanıtlayamaz. Model bir hipotezi kendi kendine “kanıtlanmış” yapamaz.
Neden bu kadar sıkı? Çünkü bir LLM’in en ikna edici olduğu an, çoğu zaman yanıldığı andır. Akıcı bir açıklama yanlış bir sayıyı kolayca örtebilir. Sayıları modelin elinden almak bu riski tasarım düzeyinde kapatıyor; modeli daha iyi bir prompt’la ikna etmeye çalışmaktan çok daha güvenilir.
Model bir şey bulursa kurala dönüşür
Peki LLM’i neden hiç kullanıyorum? Çünkü kurallar yalnızca bildiğim hataları yakalar. Bilmediğim bir hata tipi için kural yazamam; birinin önce onu görmesi gerekir.
Bunun için modele küçük bir pencere açıyorum. Veriden tabakalı bir örneklemle en fazla 100 satır seçiyorum: her kategori ve değer bandından birkaç satır. Bu satırlar “güvenilmeyen veri” olarak sarılıp modele veriliyor; içlerindeki hiçbir metin talimat sayılmıyor.
Model kuralların bilmediği bir sorun tipi görürse onu düzyazıyla raporlamıyor. Bir kural yazıyor: bir kimlik ve ihlali tanımlayan bir SQL koşulu. Ardından deterministik araç bu ek kuralla bütün veri üzerinde yeniden çalışıyor ve sayıyı o veriyor.
Model keşfediyor; ölçmeyi kod yapıyor.
Bu döngünün en sevdiğim tarafı şu: modelin bulgusu bir görüş olarak kalmıyor. Bir sonraki koşuda da, ondan sonrakinde de ölçülen bir kurala dönüşüyor. Bir hafta sonra aynı modelin aynı şeyi yeniden fark etmesine ihtiyaç kalmıyor.
Yanlış veri, eksik veriden pahalıdır
Bu cümleyi ilk duyduğumda bana sezgiye ters geldi. Boş bir hücre göze batar, yanlış bir değer ise en azından “dolu” görünür. Sonra iki hatanın maliyetini yan yana koydum.
Yanlış bir sayı, ortalamaları ve toplamları sessizce bozar. Rapor tutarlı görünür ama yanlıştır ve hatanın nereden geldiğini geriye doğru izlemek çoğu zaman imkânsızdır. Boş bir değer ise sayılır, filtrelenir, sınıflanır ve bir doldurma planına girer. Kısacası boşluk bir iş kalemidir; yanlış değer ise bir güven kaybı.
İlkeyi iki yerde koda döktüm. Çıkarım tarafında, bir alanı girdinin birden fazla yüzeyinden okuyan yapılandırmalarda yüzeyler çelişirse değer boş bırakılıyor ve çelişki ayrıca kaydediliyor. Değerlendirme tarafında ise her hücre bir zarfla yazılıyor: ya değer ve kaynağı, ya da boşsa nedeni. Neden serbest metin değil; kapalı bir listeden, belirli bir öncelik sırasıyla seçiliyor.
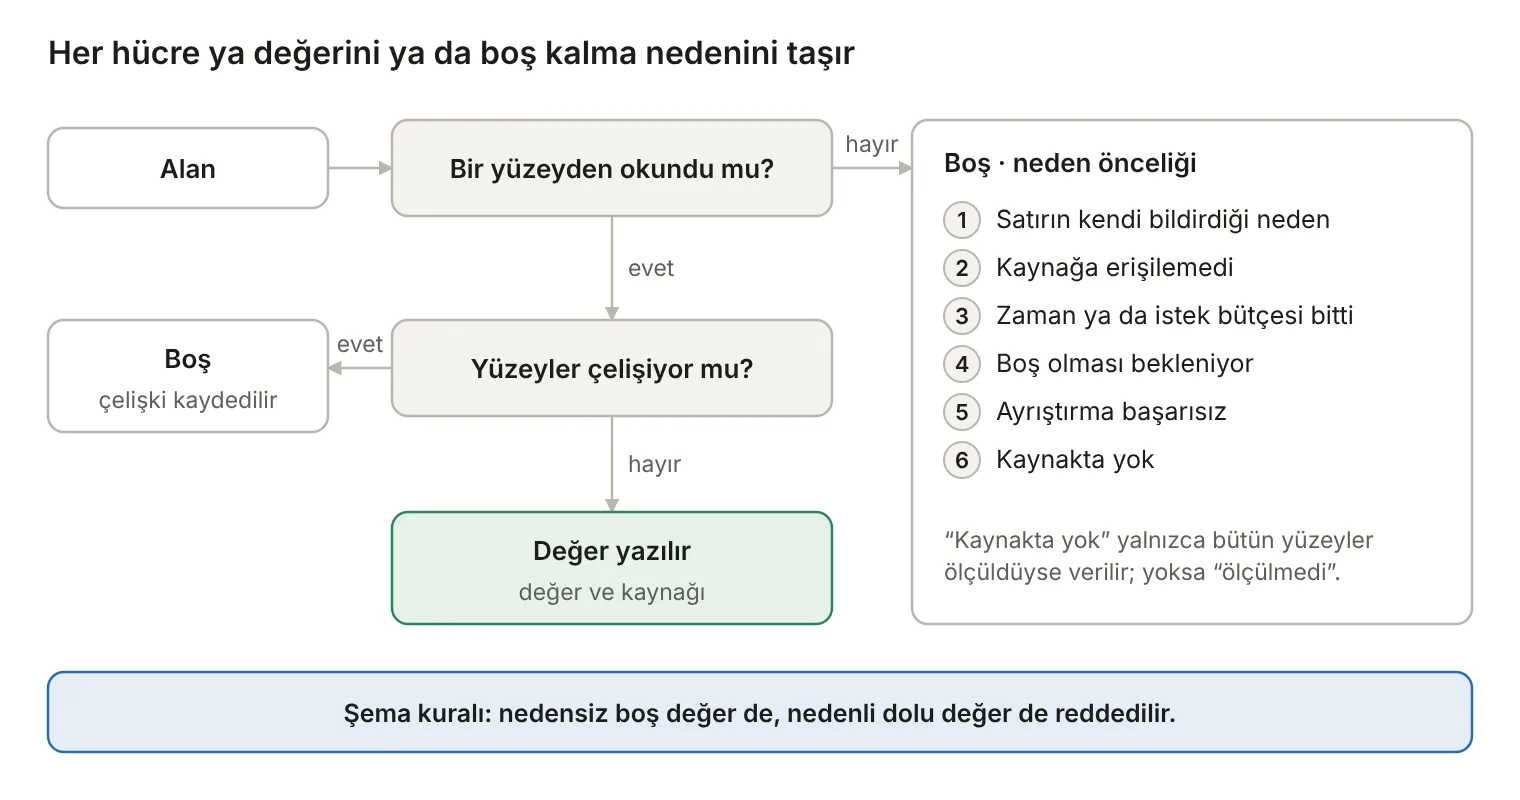
Şema iki kuralı zorluyor: nedeni olmayan bir boş değer olamaz; bir değer ile bir neden aynı anda var olamaz. Yani “sessiz null” sistemden geçemiyor. Şunu da söyleyeyim: zarfın üretim satırına taşınması ve kaynaklar arası güveni derecelendiren bir skor hâlâ açık bir karar; bugün zarfı değerlendirme koşularında kullanıyorum.
Boş hücreler sonra deterministik bir sınıflandırıcıdan geçiyor. Burada küçük ama önemli bir kural var: bir alana “kaynakta yok” diyebilmek için o alanın bulunabileceği bütün yüzeylerin ölçülmüş olması gerekiyor: yapısal meta veri, gövde metni, ekler, servis yanıtları. Biri bile ölçülmediyse bu etiketi veremiyorum; alan “ölçülmedi” kalıyor. Aksi halde “bakmadım” ile “yok”u karıştırırdım.
Boşluğu doldurmanın beş basamağı
Bir alanın boş olduğunu bilmek yetmiyor; doldurmak da gerekiyor. En kolay yol, boşlukları bir LLM’e tahmin ettirmek olurdu. Bilinçli olarak bunu yapmadım. Merdivenin her zaman ilk basamağından başlıyorum.
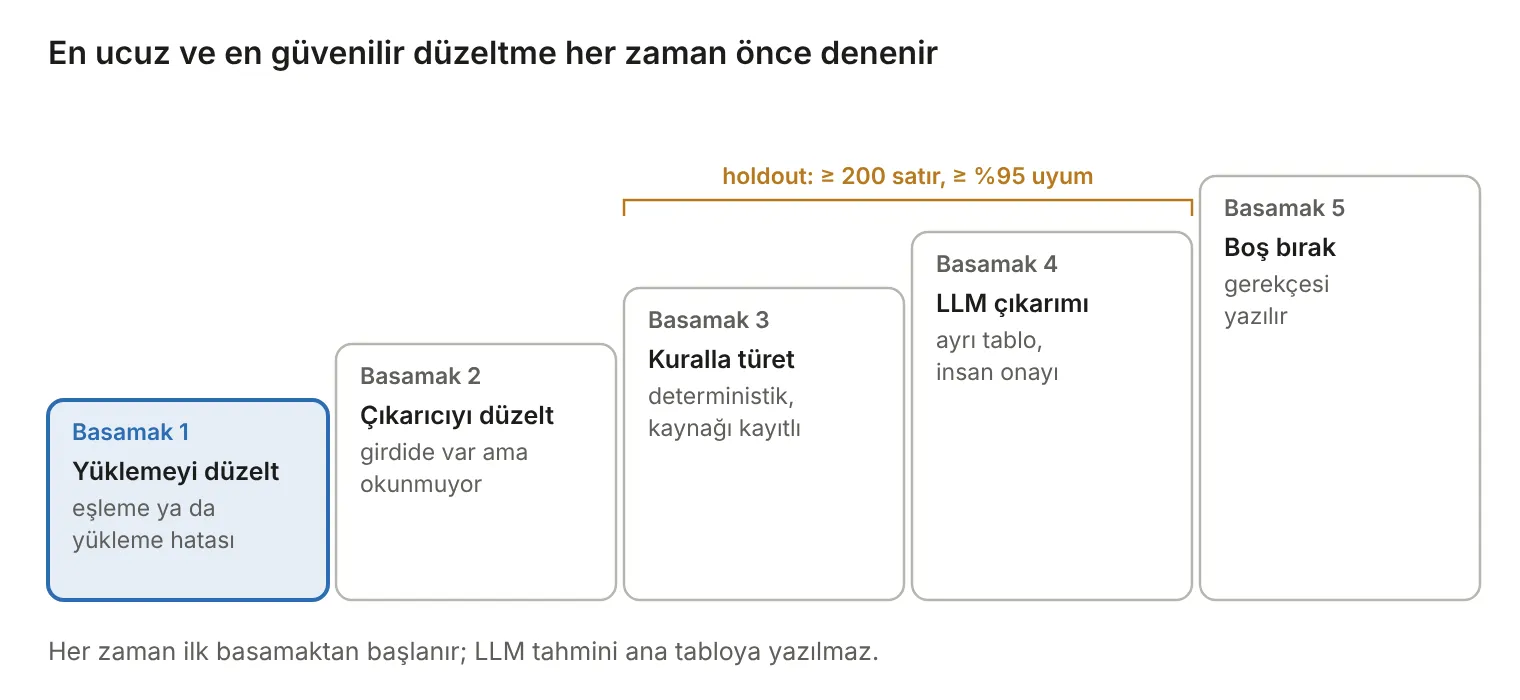
Bu sıra, en ucuz ve en güvenilir düzeltmenin hep önce denenmesini sağlıyor. Üçüncü ve dördüncü basamaklar bir holdout testinden geçmek zorunda: dolu olduğunu bildiğim en az 200 satırı saklıyor ve yöntemi onlarda deniyorum. Kategorik alanlarda %95 uyum yoksa yöntem reddediliyor. LLM çıkarımı bu testi geçse bile ana tabloya yazılmıyor; ayrı, kaynağı kayıtlı bir tabloda ve insan onayıyla duruyor.
İhlal FAIL, ölçülemeyen WARN, sessizlik yasak
Bu üç parçalı kural belki de en çok işime yarayan şey oldu. Bir metrik hesaplanamıyorsa PASS vermiyorum; “ölçülmedi” etiketiyle WARN veriyorum.
Bunun önemini bir gizlilik testini tasarlarken çok net gördüm. Test, kişisel verinin modele sızıp sızmadığını ölçüyordu. İçerik bir koruma katmanı tarafından durdurulursa modele hiç ulaşmaz ve test “0 sızıntı” diyerek PASS verir. Teknik olarak doğru, pratikte anlamsız bir sonuç.
Çözüm, önce içeriğin gerçekten modele ulaştığını doğrulayan ayrı bir kapı oldu. Ulaşmadıysa test FAIL veriyor. Burada ölçülemeyen bir metrik değil, ihlal edilmiş bir ön koşul var: testin anlamlı olması için içeriğin modele ulaşması gerekiyor. Boş bir test, başarılı bir test değildir.
Modelin beyanı kanıt değildir
Ajanlardan biri, yeni bir girdi kaynağının nasıl okunacağını kendi kendine keşfeden bir döngüde çalışıyor. Döngünün sonunda “başardım” ya da “başaramadım” diye bitiriyor.
Ölçmeye başladığımda rahatsız edici bir şey gördüm: model, deterministik değerlendiricinin FAIL dediği durumlarda da sık sık “başardım” diyordu. Bir ölçüm setinde bu fazla beyanların sayısı 83’tü.
Kural koydum: değerlendirici FAIL diyorsa modelin “başardım” beyanı reddediliyor ve koşu başarısız sayılıyor. Aynı ölçümde kabul edilen fazla beyan 0’a indi.
Model daha dürüst olmadı; dürüst olmayan beyanın bir karşılığı kalmadı.
Ajanlar arasında yetki ayrımı
Veri sağlığı işini altı rollü bir ajan ekibi yürütüyor. Yetki dağılımı bilinçli olarak dengesiz: depoya yazan tek bir rol, bulut ortamında komut çalıştıran tek bir rol var; geri kalanlar yalnızca okuyor.
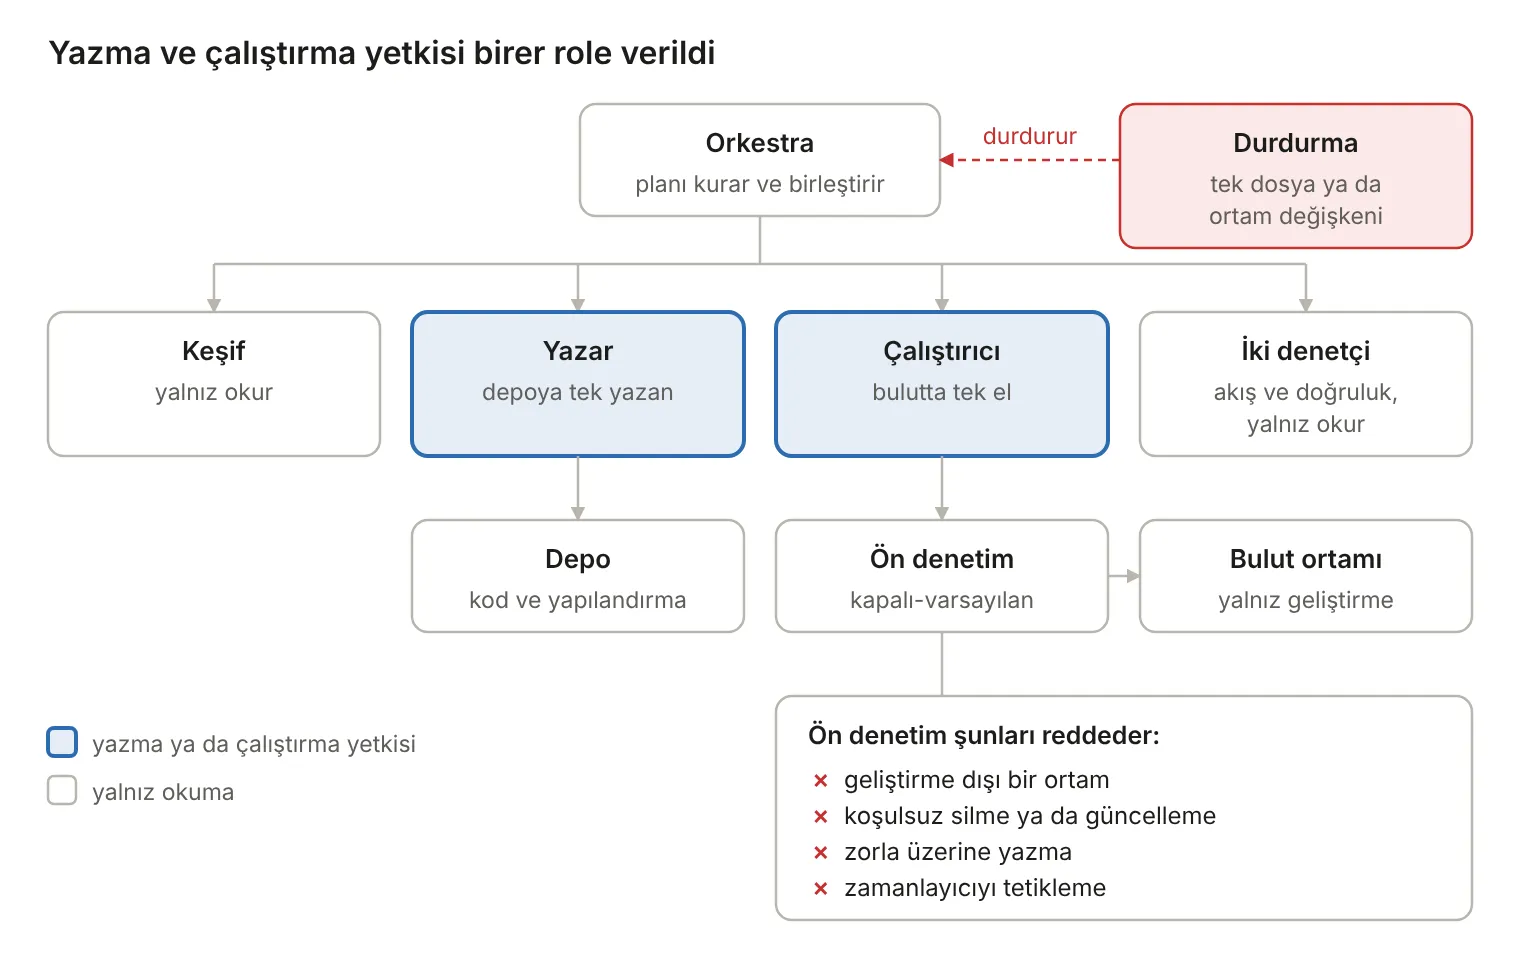
Çalıştırıcının her komutu önce kapalı-varsayılan bir ön denetimden geçiyor. Geliştirme dışı bir ortam, koşulsuz bir silme ya da güncelleme, zorla üzerine yazma ve zamanlayıcıyı tetikleme reddediliyor. Belirli bir durdurma dosyasını oluşturmak ya da tek bir ortam değişkenini ayarlamak bütün ekibi anında durduruyor.
Bu bana biraz hız kaybettirdi. Ama bir ajanın yanlış ortamda bir tabloyu silmesinin maliyetiyle karşılaştırınca pazarlık hiç zor olmadı.
Akılda kalanlar
- Güven, modelin doğru davranacağına inanmaktan değil; yanlış davrandığında sonucun sınırlı ve görünür kalmasından gelir.
- LLM’i kararın sahibi değil, keşfin ortağı yapın ve bulduğunu kurala çevirin.
- Emin olmadığınız değeri yazmayın; neden boş olduğunu yazın.
- “Ölçülmedi” bir sonuçtur, PASS değildir.
- Modelin beyanını kanıtla sınayın; beyanla kanıt ayrışıyorsa kanıt kazanır.
Sonraki yazıda bu ilkeleri ölçen on iki tekniği ve ilk koşuda bulduklarımı anlatacağım.
Rakamlar kendi ölçümlerimdir (Eylül–Ekim 2026). Proje, alan ve kurum adları bilinçli olarak yazıya alınmadı; anlatılan, kullandığım yöntem ve öğrendiklerim.
İlk kez bu sitede yayımlandı (18 Ekim 2026).