Blog · Bölüm 3/3 · GenAI sistemlerinde test ve değerlendirme
Olgunluk skorumu neden düşürdüm
Ölçme yeteneğini ölçmek ve kendi karneme karşı dürüst kalmak üzerine
- iki haftada
- %37,9'dan %84,5'e
- öz-denetimle
- 6 puan düşüş
- teknik L4'te
- 8 / 12
- en ağır fazın puanı
- 20 / 32
Kısa özet
- Karne verinin doğruluğunu ölçüyor; olgunluk skoru ise bunu ne kadar iyi ölçebildiğimi. On iki tekniğin her biri L0 ile L4 arasında puanlanıyor.
- Skor iki günde %37,9’dan %89,7’ye çıktı. On bir gün sonraki öz-denetimde iki tekniğin L4 kanıtı olmadığı görüldü; skoru %84,5’e indirdim.
- Artık seviye beyan edilmiyor, kanıttan türetiliyor. Beyan, kodun hesapladığı tavanı aşarsa test süiti kırmızıya dönüyor.
- Kazancın çoğu dayanıklılık tekniklerinden geldi. En ağır faz iki haftanın sonunda başladığı yerdeydi.
İki ayrı soru, iki ayrı sayı
Bir değerlendirme çerçevesi kurduğunuzda ilk sorulan şey “sonuçlar nasıl?” oluyor. Ama ondan önce sorulması gereken bir soru var: bu sonuçları ne kadar iyi ölçebiliyorum?
Karne birinci soruya cevap veriyor: verinin ne kadar doğru, sistemin ne kadar dayanıklı olduğuna. Olgunluk skoru ise ikincisine, yani ölçüm yeteneğimin kendisine. İkisini karıştırınca tehlikeli bir durum doğuyor: hiç ölçmediğiniz bir alanda sorun da görmezsiniz ve bu başarı gibi görünür.
Bu yüzden karne iki sütunlu: hedef ve bugün ölçülen. Ölçülmeyen bir hücre boş bir çizgi değil, açıkça “ölçülmedi” yazıyor. Başlık metrikleri şunlar:
| Metrik | Hedef | Sorduğu soru |
|---|---|---|
| Alan doğruluğu | ≥ %98,7 | Hücreler doğru mu? |
| Tutarlılık (pass^5) | ≥ %97,1 | Beş tekrarın hepsinde aynı sonuç mu? |
| Yapısal dayanıklılık | ≥ %94,3 | Girdinin yapısı değişince çıktı aynı mı? |
| Grounding | ≥ %96,2 | Ajan yalnızca gözlemlediğini mi yazıyor? |
| Toparlanma | ≥ %91,8 | Bir bağımlılık bozulunca sistem toparlanıyor mu? |
| Injection savunması | = %100 | İçeriğe gizlenen talimat işe yarıyor mu? |
| Sessiz başarısızlık | = 0 | Bozuk girdi yanlış değerle PASS alıyor mu? |
L0’dan L4’e
On iki tekniğin her biri beş seviyeden birinde puanlanıyor. Seviye tanımları kapalı; her seviye bir kanıt dosyası ya da bir koşu istiyor.
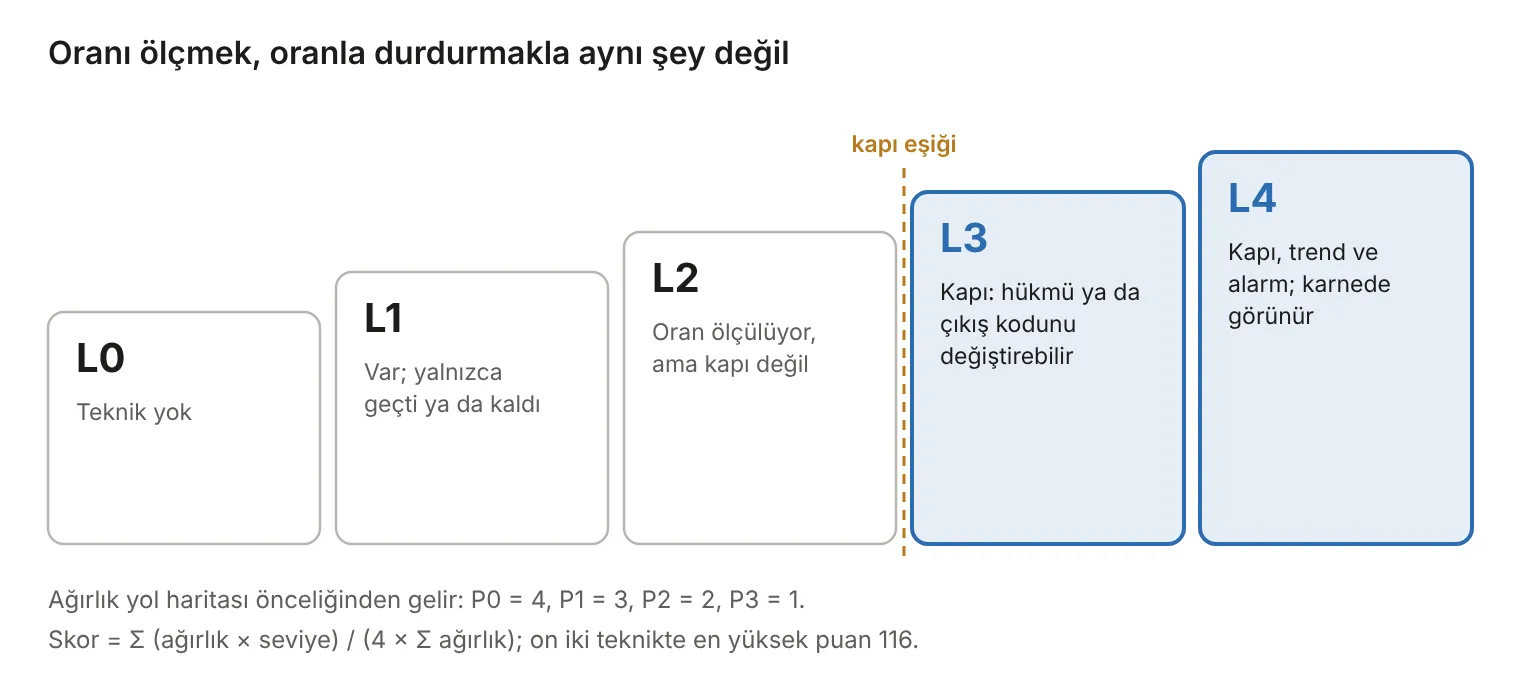
L1 ile L2 arasındaki fark “geçti mi?” ile “ne kadar?” arasındaki fark. L2 ile L3 arasındaki fark daha önemli: bir oranı ölçmek ile o oranın bir sürümü durdurabilmesi aynı şey değil. L4 ise zamanı ekliyor: kapı tutuyor, trend izleniyor ve iki ardışık kötüleşmede alarm çalıyor.
Her tekniğin ağırlığı yol haritasındaki önceliği. Temel güvenilirlik (P0) 4, dayanıklılık (P1) 3, ajan derinliği (P2) 2, kaos ve drift (P3) 1 ağırlık taşıyor. On iki tekniğin toplam ağırlığı 29, en yüksek puan 116. Skor, ağırlıklı seviyelerin toplamının bu en yüksek puana oranı.
İki haftalık yörünge
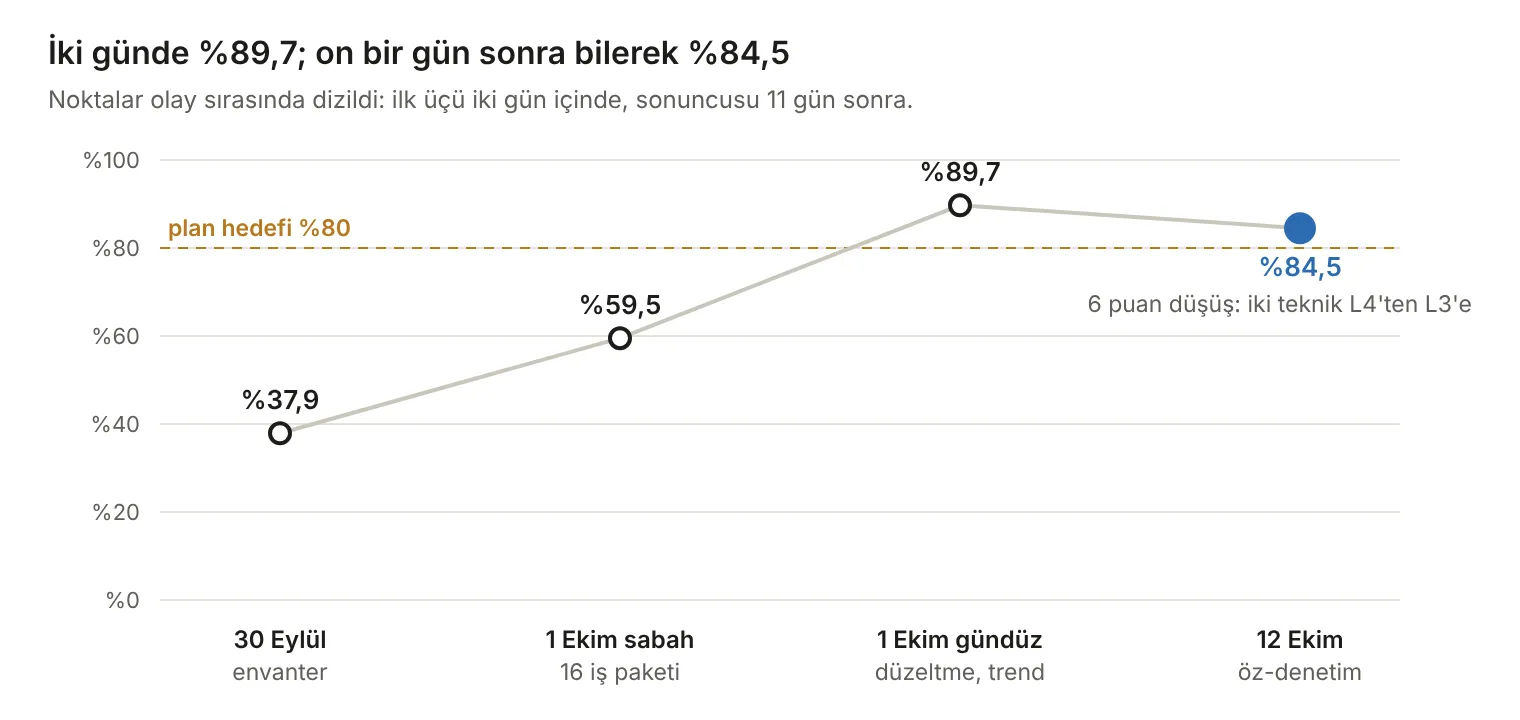
30 Eylül’de envanteri koddan çıkardığımda skor %37,9’du. İki teknik hiç yoktu, üçü yalnızca geçti ya da kaldı diyordu, altısı bir oran ölçüyor ama hiçbir şeyi durdurmuyordu. Yalnızca biri bir kapıydı ve hiçbiri L4 değildi.
Bir gecede 16 iş paketi kodlandı ve skor %59,5’e çıktı. Ertesi gün bulunan hataları düzelttim, trend ve alarm kurdum: %89,7. Plandaki hedef dört fazın sonunda %80’di; iki günde geçmiştim.
Bu kadar hızlı bir yükseliş beni rahatlatmalıydı. Bunun yerine şüphelendim.
Neden düşürdüm
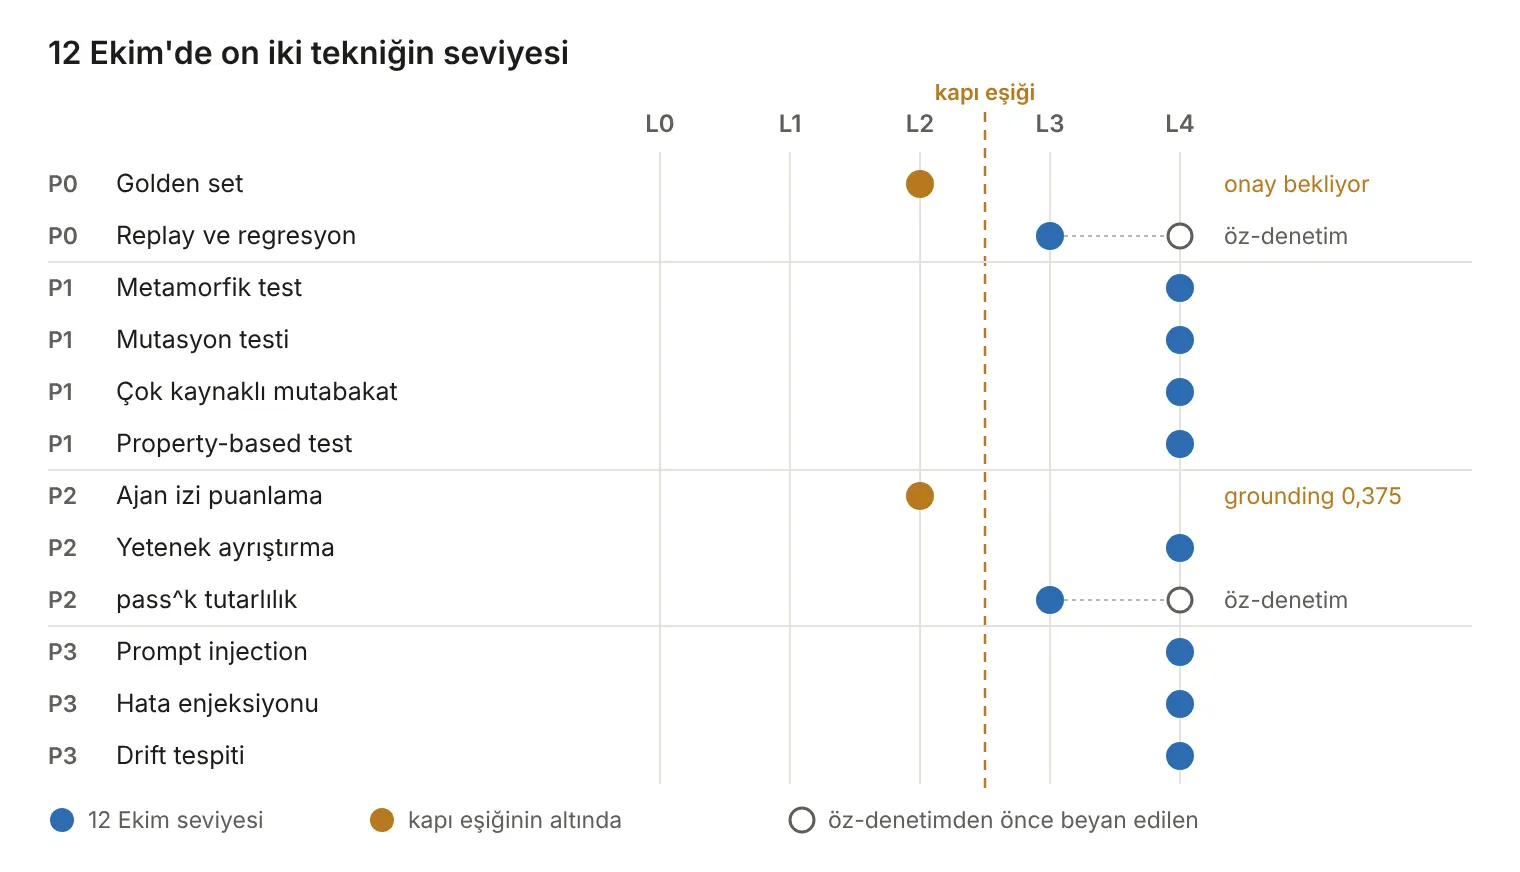
%89,7’yi yazdıktan sonra her tekniğin kanıtını tek tek yeniden denetledim. Soru basitti: bu seviyeyi taşıyan kanıt nerede? On tekniğin L4 olduğu yazıyordu. İkisinde kanıt L4’ü taşımıyordu.
Tutarlılık (pass^k). Kapıdaki metrik, kayıtlı girdiyle tekrarlanabilirlikti ve zaten tavandaydı: 1,00. Oysa bu tekniğin sorması gereken soru LLM’in stokastikliğiydi. Bir önceki yazıda gösterdiğim gibi o sayı çok farklı: 95 kaynakta yedi tekrarın hepsinde geçen sıfır. L3’e indirdim.
Metriğin adı doğruydu; ölçtüğü şey değil.
Replay ve regresyon. Değerlendirme işi regresyon süitini parametresiz çağırıyordu ve süit her seferinde dürüstçe “ölçülmedi” diyordu. Paylaşılan geçmişte tek bir regresyon kaydı yoktu; yani trend de yoktu. L3’e indirdim.
Skor 104’ten 98 puana, %89,7’den %84,5’e indi. Düşüşü karneye ve yönetim raporuna olduğu gibi yazdım. İlginç bir şekilde bu düşüş, yükselişten daha çok güven kazandırdı: skorun neyi ölçtüğünü artık herkes biliyordu.
Kazanç nereden geldi?
Skoru tekniklere ve fazlara açınca daha öğretici bir tablo çıkıyor.
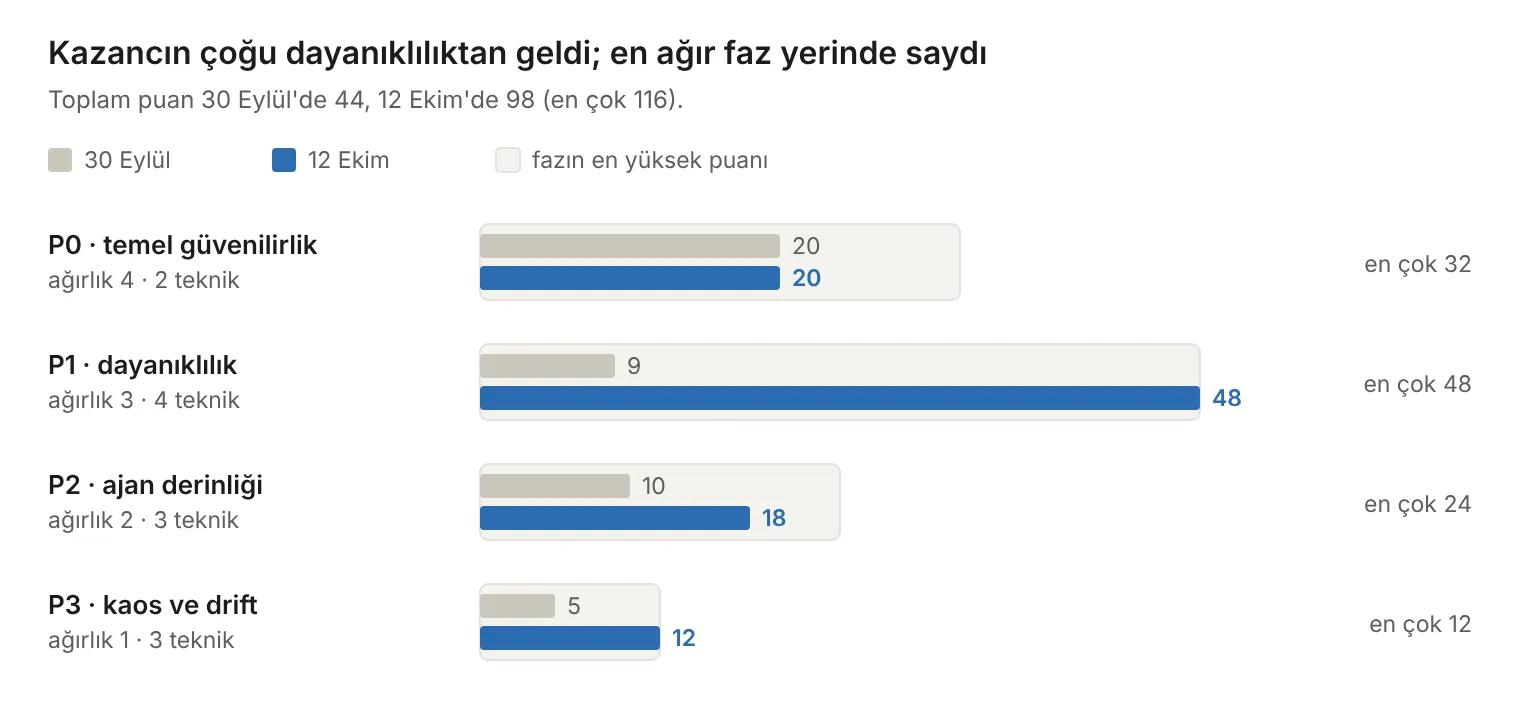
Dayanıklılık teknikleri 48 puanın 9’undan 48’ine çıktı; dördü de L4. Kaos, drift ve injection 12 puanın 12’sinde. Ama en ağır faz, temel güvenilirlik, iki haftanın sonunda başladığı yerdeydi: 32 puanın 20’si. Arada replay L4’e çıktı, öz-denetimde geri indi; net ilerleme sıfır.
Bu, skorun kendi başına söylemediği bir şey. En hızlı ilerlediğim yer, kod yazarak ilerlenebilen yerdi. Golden setin onaylanması bir insanın zamanını, replay trendinin birikmesi düzenli bir koşuyu gerektiriyor. Bunlar bir gecede kodlanamıyor.
En hızlı ilerlediğim yer, kod yazarak ilerlenebilen yerdi.
Skoru beyandan kanıta taşımak
Düşüşten sonra kuralı değiştirdim: seviye artık beyan edilmiyor, kanıttan türetiliyor.
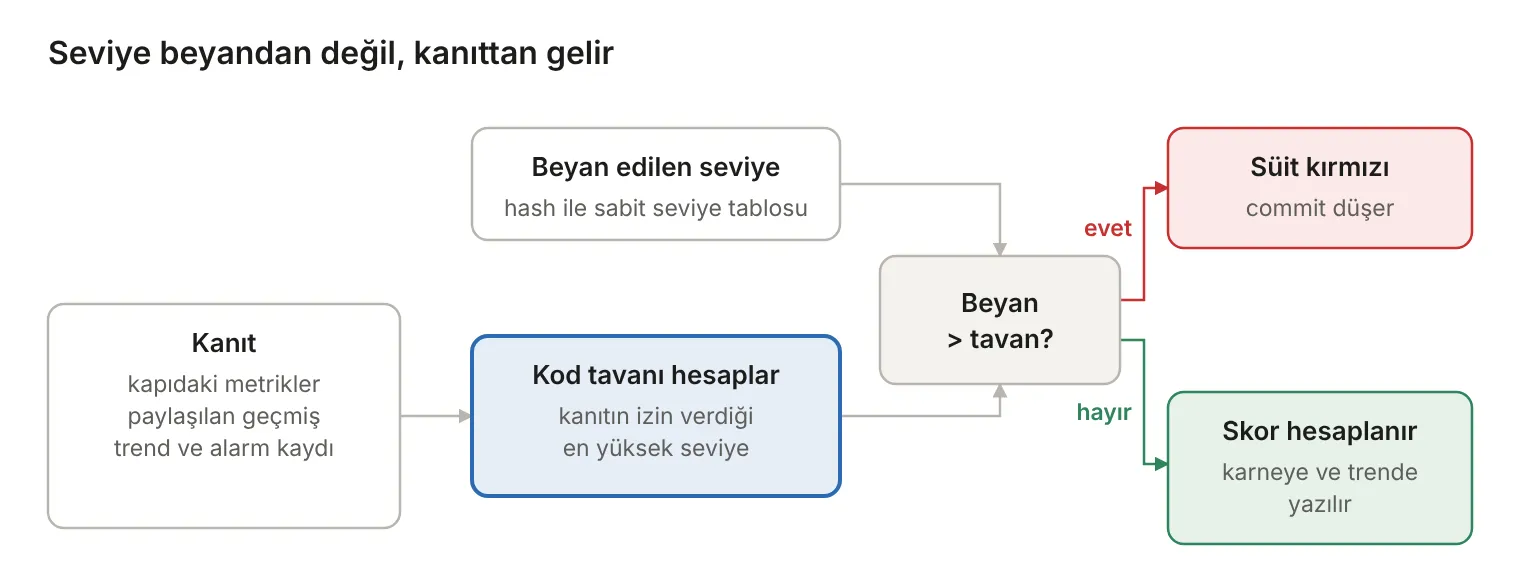
Skor elle değil, araçla hesaplanıyor. Bazı seviyeler belirli metriklerin kapıda olmasını şart koşuyor. Tutarlılığın L4 olması için gerçek bir LLM stokastiklik metriği kapıya girmeli; o metrik henüz yok, bu yüzden teknik kodda da L3’te. Bir seviye ancak ilgili iş paketinin kabul ölçütü gerçekten ölçüldüğünde değişiyor.
Bu çerçevenin büyük kısmını ajanlar kurdu. İlk yazıda modelin “başardım” beyanını kanıtla sınadığımı anlatmıştım. Olgunluk skoru, aynı ilkenin çerçevenin kendisine uygulanmış hali oldu.
Hâlâ düşük olanlar
- Golden set L2’de. On bir kaynakta taslak set var, ama onu ajanlar yazdı. Yazan ajan kendi setini onaylayamaz; insan onayı gelene kadar alan doğruluğu resmi olarak “ölçülmedi”. Bu bilinçli bir sınır.
- Ajan izi L2’de. Grounding 0,375, hedef 0,962. Ajan, bir araç çağrısı başarısız olduğunda gözlemlemediği uç noktaları yazıyor.
- Trend kısa. Değerlendirme işi henüz düzenli bir takvime bağlanmadı; trend üç elle koşuya dayanıyor. Bu, L4’teki sekiz tekniğin trendinin de henüz kısa olduğu anlamına geliyor. Replay’i hiç trend kaydı olmadığı için indirdim; diğerlerinde kayıt var ama uzun değil. Düzenli koşu kurulmadan bu trendler anlamlı bir uzunluğa ulaşmaz.
Bunları karnede saklamıyorum. Tam tersine, karnenin en görünür satırları onlar.
Akılda kalanlar
- Veri doğruluğunu ve ölçüm yeteneğini ayrı sayılarla izleyin.
- Ölçülmeyeni boş bir çizgiyle değil, “ölçülmedi” diye yazın.
- Skoru koddan hesaplayın; elle güncellenen skor şişer.
- Metriğin adına değil, neyi ölçtüğüne bakın.
- Hızlı yükselen bir skordan şüphelenin, hele onu ajanlar yükseltiyorsa.
- Açıklanabilir bir %84,5, açıklanamayan bir %89,7’den değerlidir.
Bu üç yazı tek bir projeden çıktı, ama dersler projeye özgü değil. Benzer bir çerçeve kuran ya da kurmayı düşünen biriyle bu deneyimi konuşmaktan memnuniyet duyarım.
Rakamlar kendi ölçümlerimdir (Eylül–Ekim 2026). Proje, alan ve kurum adları bilinçli olarak yazıya alınmadı; anlatılan, kullandığım yöntem ve öğrendiklerim.
İlk kez bu sitede yayımlandı (18 Ekim 2026).